BEPRO Dev Team
Miglioramento del nostro processo di raccolta dei dati di tracciamento calcistico
In che modo l'utilizzo di MLOps sta facendo la differenza in BEPRO

Sei stanco di gestire manualmente i dataset e di cercare di tenere traccia di quale hai utilizzato per un particolare esperimento?
O forse hai addestrato il tuo modello di produzione diversi anni fa e ora hai paura di toccarlo, anche se i dati con cui ha a che fare adesso potrebbero essere diversi?
Forse non ti importa nulla di tutto questo e vuoi solo migliorare le metriche del tuo modello, ma dopo aver provato tutte le combinazioni di architettura e iperparametri non hai comunque raggiunto l'obiettivo?
Sorprendentemente, in tutti questi scenari, potresti trarre vantaggio dall'“adozione di MLOps”.
Qui descriveremo alcuni passi che abbiamo compiuto in questa direzione, sperando che possano rivelarsi utili o quantomeno interessanti.
Cos'è MLOps?
Prima di procedere, dobbiamo innanzitutto concordare su cosa sia esattamente MLOps. Consultiamo prima alcune grandi aziende.
Documentazione di Google Cloud:
MLOps è una cultura e una pratica di ingegneria del ML che mira a unificare lo sviluppo dei sistemi ML (Dev) e l'operatività dei sistemi ML (Ops).
Uhm, questo non è stato particolarmente illuminante.
Abbreviazione di machine learning operations, MLOps è un insieme di best practice che consente alle aziende di gestire l'IA con successo.
Questo è già più interessante, ma ancora piuttosto vago.
Documentazione di Azure (Microsoft):
MLOps — machine learning operations, o DevOps per il machine learning — consente ai team di data science e IT di collaborare e aumentare il ritmo di sviluppo e implementazione dei modelli attraverso il monitoraggio, la convalida e la governance dei modelli di machine learning.
Credo che più dettagliato di così non si possa.
Se proviamo a riassumere queste definizioni, MLOps è un insieme di pratiche che aiutano nello sviluppo di modelli di IA.
Ma se chiediamo ad Andrew Ng, la risposta sarà leggermente diversa. Può essere grossomodo riformulata così: se cerchiamo di migliorare le prestazioni del sistema, forse dovremmo concentrarci meno sui modelli e più sui dati; e nel video collegato fornisce alcuni esempi delle motivazioni alla base di ciò.
Queste due prospettive non sono in diretta contraddizione, eppure la differenza in ciò che viene enfatizzato ci dice una cosa importante: MLOps è interessante per motivi diversi, e dipende da a chi lo stai "vendendo", se a un imprenditore o a un ingegnere, a un'azienda enterprise o a una startup.
Forse un altro modo di vedere la questione sarebbe analizzare il principale potenziale di miglioramento in un servizio di ML — metriche migliori? Meno lavoro manuale per ogni iterazione di aggiornamento del modello? Deployment più stabili? Meno regressioni? — e poi affrontarlo sistematicamente con misure concrete.
Ciò significherebbe che "adottare MLOps" è una sorta di termine ombrello, che potrebbe significare cose diverse per aziende diverse in fasi diverse; quindi, per essere più specifici, ci concentreremo su aspetti particolari che erano importanti per noi di BEPRO.
MLOps in BEPRO
Per noi, sembrava che il miglior punto di partenza per l'adozione delle pratiche MLOps fosse l'automazione delle procedure di raccolta dei dataset, facendo sì che ciò avvenisse a intervalli regolari.
In precedenza, un dataset veniva raccolto manualmente secondo determinati criteri (campo, squadre, condizioni meteorologiche, ecc.) e veniva consegnato a una società terza per l'annotazione. Ma durante il ciclo di vita del prodotto vengono già generati molti dati annotati, e non utilizzarli sarebbe uno spreco.
Inoltre, incorporare immediatamente i dati acquisiti significherebbe ridurre la possibilità che i modelli diventino obsoleti (una volta che iniziamo a operare su nuovi campi, con nuove squadre, condizioni meteorologiche più variegate, ecc.) e offrire opportunità per raccogliere più dati in modo mirato (campioni in cui i modelli attuali non sono abbastanza accurati).
Infine, se il processo di raccolta/preparazione dei dati non viene eseguito frequentemente, diventa spesso una "conoscenza sacra", che va persa oppure è nota solo a pochi ingegneri selezionati, rendendo più difficile verificare nuove ipotesi (a volte al punto da evitare del tutto tali compiti).
Non solo "adottare MLOps" renderebbe il processo di raccolta dati più trasparente e sistematico, ma ci consentirebbe anche di aumentare in modo molto significativo (ordini di grandezza) le dimensioni del dataset per quanto riguarda il numero di campioni e il numero di partite, il che dovrebbe migliorare sensibilmente le metriche del modello.
Ricerca iniziale
Per evitare di reinventare la ruota, abbiamo utilizzato strumenti open source già pronti all'uso che aiutano nella gestione e nell'automazione dei dataset.
Gestione dei dataset
Lavoriamo con dataset (versionati) in cui ciascuna versione contiene milioni di file per centinaia di gigabyte, quindi la velocità e l'efficienza dello storage sono fondamentali. Per gestirli abbiamo deciso di utilizzare DVC, poiché non intralcia il lavoro e ha un'interfaccia simile a git che lo rende più facile da padroneggiare (anche se inizialmente potrebbe richiedere un po' di impegno per acquisire familiarità).
Ci interessano principalmente i seguenti punti:
Caricare/scaricare facilmente il dataset sul cloud storage di nostra scelta utilizzando qualsiasi macchina (aiuta a scalare l'addestramento/la ricerca degli iperparametri)
Evitare l'uso di storage aggiuntivo/larghezza di banda di trasferimento se diversi dataset o versioni di dataset si sovrappongono in termini di campioni
Assicurarsi che la versione dei dati sia esattamente equivalente tra le macchine senza passaggi manuali (meno spazio per l'errore umano)
Il punto uno dovrebbe probabilmente essere dato per scontato per un sistema di gestione dei dataset, quindi qui ci concentreremo sul punto due (e realizzarlo correttamente implica anche il terzo punto).
Supponi di avere due dataset (o versioni dello stesso dataset) A e B, che contengono rispettivamente i campioni {1, 2, 3, 4, 5} e {2, 3, 4, 5, 6}.
Le soluzioni ingenue li memorizzerebbero separatamente, richiedendo spazio per 10 campioni, ma con DVC memorizzerai solo sei campioni e alcuni dati aggiuntivi per definire quale dataset ha quali campioni (il che sarebbe in genere trascurabile purché si lavori con campioni binari relativamente grandi).
Se abbiamo già il dataset A in locale e vogliamo scaricare il dataset B, dovrai scaricare un solo campione invece di cinque.
Questo esempio potrebbe sembrare banale, ma avere un sistema in grado di gestirlo in modo efficiente ha un impatto molto significativo sui requisiti di storage e larghezza di banda, nonché sulla velocità delle operazioni, che diventano critici non appena si inizia a creare regolarmente nuove versioni di dataset in modo automatizzato, caricandoli su cloud e scaricandoli sulle macchine agent per l'addestramento o altri scopi.
Inoltre, nel nostro caso potrebbe essere possibile avere dataset per attività diverse (rilevamento di oggetti, riconoscimento del numero di maglia del giocatore, stima della posizione della telecamera, ecc.) che condividono le immagini ma hanno etichette separate, senza aumentare l'uso dello storage sul cloud. Naturalmente è possibile ottenerlo anche manualmente, ma ciò richiederebbe un coordinamento tra le persone che gestiscono i diversi dataset, mentre in questo caso possono eseguire il push/pull dei propri dati sullo storage in modo indipendente, e questi verranno riutilizzati il più possibile dietro le quinte.
Anche con questo approccio è comunque necessario prestare particolare attenzione durante la raccolta dei dati per garantire che la cache venga riutilizzata il più possibile senza sacrificare le prestazioni del modello: ne parleremo più avanti.
Automazione e integrazione
Poiché utilizziamo GitHub come archivio di repository, è stata una scelta naturale utilizzare GitHub Actions per automatizzare alcuni job.
Molti dei job richiederebbero tempi di esecuzione relativamente lunghi e l'uso di una GPU, quindi avevamo bisogno di utilizzare agent personalizzati invece di quelli forniti da GitHub.
Per farlo, abbiamo utilizzato CML, che consente anche di inviare report sotto forma di commenti a commit e PR.
Oltre ai tipici utilizzi dello sviluppo software (eseguire lint e test per ogni commit/PR), abbiamo utilizzato diversi job attivati manualmente:
Creare un report sui campioni disponibili per l'inclusione nel dataset (una comoda tabella markdown che ci consente di confrontare il dataset da esportare con uno precedente per determinare se vale la pena riaddestrare il modello)
L'esportazione effettiva del dataset, con la possibilità di selezionare il branch del repo con il codice e la configurazione da utilizzare e anche di sovrascrivere alcune delle impostazioni di esportazione (dimensione del dataset, ecc.)
È possibile eseguire l'esportazione automaticamente secondo una pianificazione, ma non aveva senso eseguirla più di una volta al mese, quindi non c'era molto da guadagnare in termini di tempo risparmiato. Lo stesso vale per l'addestramento del modello con il dataset aggiornato: in linea di principio è facile da fare, ma automatizzarlo ridurrebbe il livello di controllo che abbiamo sul processo e non libererebbe molto tempo.
Un aspetto pratico dell'attuale integrazione è che, una volta completata l'esportazione del dataset, i dati vengono caricati automaticamente sul cloud storage tramite DVC e gli identificatori per i dati caricati vengono pubblicati come commenti sotto il commit utilizzato per eseguire l'esportazione, insieme al contenuto del file di configurazione che determina le impostazioni di esportazione. Ciò garantisce che sia facile trovare una particolare versione del dataset e che questa non vada persa, a differenza di uno scenario in cui i dataset vengono gestiti manualmente.
In questo modo, gli sviluppatori che non lavorano direttamente con questo sistema possono utilizzare i dataset esportati nei loro progetti, senza dover eseguire personalmente alcuna raccolta o pulizia dei dati (permettendoci di avere specialisti separati che si concentrano sulla pulizia dei dati e sull'addestramento dei modelli).
Progetto pilota
In questo caso, utilizzeremo come esempio l'attività di tracciamento di oggetti multipli (multiple object tracking). In questo caso, un'immagine è l'input del modello e l'output atteso è un insieme di bounding box, ciascuna accompagnata da una classe di oggetto (giocatore, palla, ecc.) e da un vettore di embedding, che verrà utilizzato durante la fase di re-identificazione.
Ottenimento delle etichette
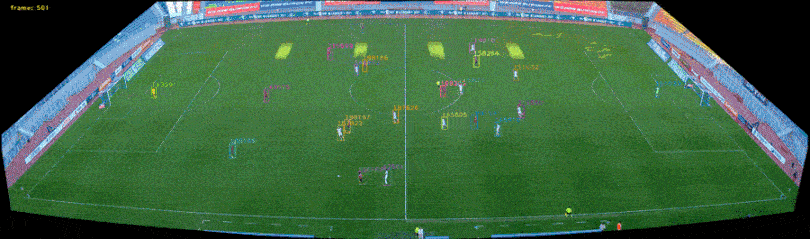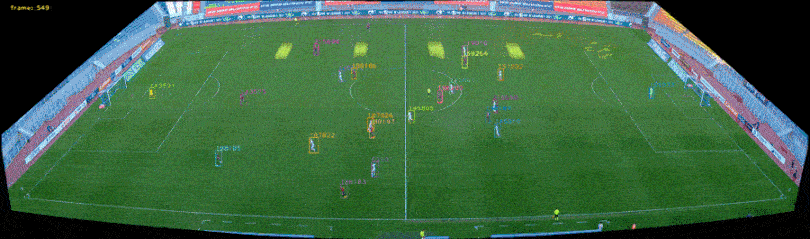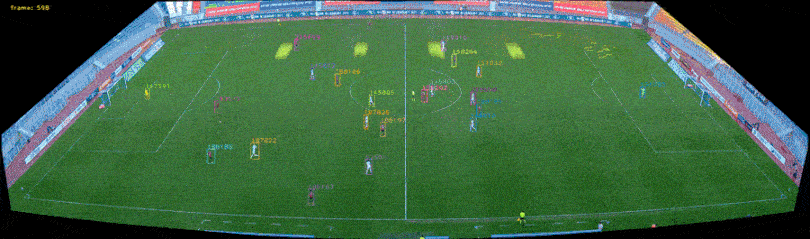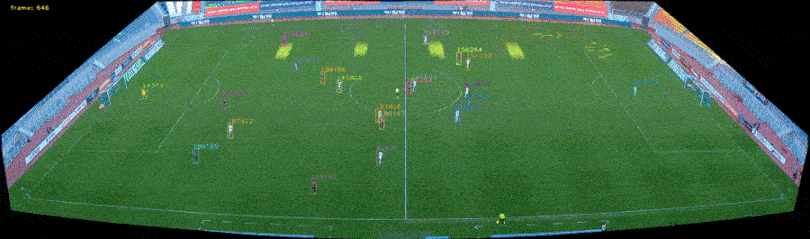
Durante il ciclo di vita del nostro prodotto, le previsioni dei modelli vengono esaminate da esperti umani e i risultati corretti (bounding box, etichette di classe e identità del giocatore) vengono salvati in un database, fornendo una fonte di dati che possiamo considerare come ground truth.
Ecco un esempio delle bounding box con i relativi ID dei giocatori sovrapposti all'immagine:
In un mondo ideale l'avremmo utilizzato così com'è, ma nel nostro caso dobbiamo prima effettuare una pulizia.
Un esempio di caso che richiede particolare attenzione:
Quando un esperto umano corregge i riquadri mancanti, questi vengono posizionati solo nei frame in cui il vettore di velocità del giocatore cambia, e si prevede che le loro posizioni nei frame rimanenti vengano interpolate
Quando un giocatore attraversa la linea laterale per lasciare il campo, non viene incluso nell'annotazione finché non è rientrato in campo
Quando le due condizioni sopra menzionate si combinano, vengono generati segmenti di traiettoria "fantasma" (un riquadro che si muove lentamente dal punto di uscita al punto di ingresso sul campo) e, a meno che non venga eseguita una pulizia dei dati, tali artefatti influenzeranno negativamente il modello addestrato
Un altro potenziale problema è la sincronizzazione tra fotogrammi video ed etichette, che a volte potrebbe essere leggermente imprecisa. Non è un problema per gli utenti del prodotto, ma durante l'addestramento del modello anche lo scostamento di un singolo frame ha un impatto negativo, quindi idealmente dovrebbe essere compensato.
Affrontiamo entrambi i problemi confrontando le etichette con gli output del miglior modello disponibile e stimando quindi:
L'offset ottimale per la sincronizzazione di etichette e frame
L'allineamento tra etichette corrette e previsioni (si potrebbe usare la loss, l'IoU o qualsiasi altra misura significativa)
Quindi, utilizzando queste informazioni, possiamo filtrare i campioni per includere solo quelli con una ragionevole concordanza tra le etichette e l'output del modello.
Selezione dei campioni
Dopo rapidi calcoli approssimativi è diventato evidente che non sarebbe stato possibile includere tutti i campioni che abbiamo nel nostro dataset a causa delle dimensioni previste. Poiché lavoriamo con dati basati su video, i campioni consecutivi sono fortemente correlati, il che rende l'inclusione di tutti ancora meno sensata. Infine, a causa della natura del processo che utilizziamo per ottenere le etichette di ground truth, alcune di queste sono meno accurate di altre, rendendo indesiderabile la loro inclusione.
Tenendo presente questo, siamo giunti alla seguente strategia:
Per un dato parametro di passo dei frame e per l'intervallo di frame pertinenti, preparare un elenco di indici di frame per i candidati all'esportazione
Scartare gli indici dei frame per i campioni in cui il numero di giocatori nell'etichetta non corrisponde alle aspettative (principalmente per escludere situazioni non di gioco)
Misurare la concordanza tra le etichette di ciascuno di essi e l'output del miglior modello attuale, scartando gli indici per i frame con discrepanze estreme
Questi punti riguardavano principalmente la selezione dei campioni da un video, ma la selezione può essere applicata anche all'insieme dei video. Si possono impiegare strategie diverse e, sebbene non sia chiaro quale sia la migliore, abbiamo deciso di puntare sulla massimizzazione della diversità dei dati entro un budget fisso di campioni. Si può esprimere grossomodo così: "dovendo scegliere se includere il campione A o il campione B nel dataset, includi quello più 'inedito' (che ha già meno campioni simili nel dataset), ripeti N volte".
Come si può determinare se i video sono "simili" o meno? Nel nostro caso, a ciascun video viene assegnato un insieme di proprietà categoriche (campo, squadra di casa, squadra in trasferta, ecc.) e una combinazione di queste proprietà definisce un "gruppo". Per ogni gruppo includiamo fino a un numero limitato di video, uno dei quali va al set di validazione e il resto a quello di addestramento. Tale procedura garantisce che non vi sia uno squilibrio estremo tra le dimensioni dei gruppi ed evita che venga utilizzato troppo storage per i gruppi ben rappresentati.
Caching
Anche con queste misure, scaricare (e pre-elaborare) i campioni da zero ogni volta che viene eseguita l'esportazione richiederebbe una quantità di tempo inaccettabile, costringendoci a impiegare il caching per ciascuno dei passaggi (e strategie per l'invalidazione della cache). Disporre solo di un meccanismo di caching non è però sufficiente, poiché bisogna anche assicurarsi di selezionare e memorizzare i campioni in modo favorevole alla cache.
Ciò significa che, ad esempio, se al momento t1 selezioniamo le partite M1, al momento t2 (quando sono disponibili più dati) M2 dovrebbe essere un superset di M1 (includere tutte le partite che avevamo in precedenza + alcune nuove), e i criteri di selezione (scegli N partite da G) non dovrebbero cambiare.
Come esempio, confrontiamo due criteri per la scelta di un sottoinsieme di campioni da un gruppo: utilizzare gli N più recenti o gli N più vecchi disponibili. Se dovessimo utilizzare i più recenti, tale sottoinsieme potrebbe cambiare dopo ogni riesportazione, rendendo inutilizzati alcuni campioni nella cache e richiedendo il download di nuovi campioni. Ma se usiamo i campioni più vecchi tali problemi non si presentano, rendendo il caching più efficace.
Dopo aver implementato tutto questo, l'esportazione regolare scaricherà e pre-elaborerà i campioni solo in modo incrementale, evitando la maggior parte del dispendio di tempo. Inoltre, invece di necessitare di sum(dimensione di ciascuna versione del dataset), avremo bisogno solo di max(dimensione del dataset) (ipotizzando che i dataset non siano disgiunti nei campioni).
Download dei campioni
L'approccio ingenuo consisterebbe nello scaricare il file video per poi estrarne i frame utilizzando OpenCV o un altro strumento, ma a seconda del numero di frame che verrebbero estratti dal video ciò potrebbe risultare inefficiente (ipotizzando di aver bisogno di un solo frame da un video di tre ore come esempio estremo).
ffmpeg viene in soccorso! Con esso, possiamo estrarre un frame specifico da un video remoto senza scaricare l'intero file. Inizialmente avevamo dubbi sulla precisione della selezione dei frame, poiché il "fast seeking" con ffmpeg è possibile solo specificando l'offset temporale e non l'indice del frame. Naturalmente, conoscendo il frame rate del video dovresti essere in grado di dedurre l'offset temporale per un particolare frame, ma facendo questo devi presumere che l'intervallo di tempo tra i frame sia molto coerente per l'intero video e che la funzionalità di ricerca sia sufficientemente precisa. Fortunatamente, tale approccio è stato abbastanza accurato per il nostro caso d'uso, quindi lo abbiamo mantenuto.
L'unico problema è stato lavorare con playlist m3u8 invece che con file mp4: ffmpeg non era in grado di eseguire un fast seek accurato fino al timestamp esatto, il che si traduceva in molti frame con una grave discrepanza tra immagine ed etichette. Abbiamo risolto il problema in modo relativamente semplice, eseguendo prima un fast seek a un timecode di qualche secondo prima del frame di interesse, per poi effettuare un seek "accurato" o "lento" fino all'esatto timecode del frame di cui abbiamo bisogno; ha funzionato abbastanza bene per il nostro caso d'uso.
Infine, al fine di velocizzare l'intero processo, i frame vengono acquisiti utilizzando questo processo in parallelo, mediante un numero predeterminato di processi che dipende dalla rete, dalla CPU e dai dati di input.
Benchmarking
Finora ci siamo riferiti principalmente a uno scenario in cui i dati acquisiti vengono utilizzati per addestrare il modello. Ma ovviamente questa non è l'unica potenziale applicazione, e potrebbe essere utilizzato anche per il benchmarking end-to-end del sistema.
Nel nostro caso significava lavorare con i video invece che con le immagini e misurare le metriche importanti per il prodotto (e che potrebbero essere più difficili da misurare quando uno o tutti i modelli vengono addestrati isolatamente). Utilizzando i gruppi di campioni stabiliti durante la raccolta dei dati, potremmo generare (o aggiornare) automaticamente una serie di input e output attesi per i benchmark (relativi a qualità e prestazioni).
Un problema evidente di un benchmark così "dinamico" è il confronto dei risultati di modelli che sono stati valutati su "versioni" diverse del benchmark. Affrontiamo la questione nel modo seguente:
Una volta che il campione (video) è stato incluso nel benchmark, non può essere escluso; è possibile solo aggiungere nuovi campioni (a meno che non si desideri invalidarlo completamente)
Le metriche vengono misurate e memorizzate per ogni singolo campione (consentendo di "aggiornare" i risultati precedenti in modo incrementale, anziché ricalcolarli completamente)
Una volta inclusi nuovi campioni, i vecchi modelli vengono semplicemente valutati su questi nuovi campioni e i risultati aggregati del benchmark vengono aggiornati
Tale approccio ci consente di evitare costose riesecuzioni ed è relativamente facile da realizzare.
Risultati
Ci si potrebbe chiedere se sia valsa la pena affrontare tutti questi passaggi. Nel nostro caso è stato sicuramente così:
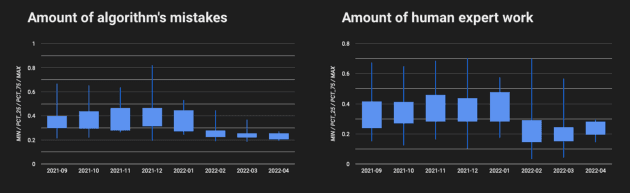
Utilizzando i dati raccolti mediante i passaggi descritti sopra, siamo stati in grado di ottenere una riduzione dell'errore > 40% nell'attività di tracciamento di oggetti multipli (tipi diversi di errori hanno pesi diversi, il che è argomento per un altro articolo🙂)
Di conseguenza, la quantità di lavoro svolto dagli esperti umani è diminuita di oltre il 25%, riducendo notevolmente il costo netto di fornitura del servizio
Eseguire nuovamente a intervalli regolari la pipeline di raccolta del dataset non richiede più di pochi minuti del tempo degli sviluppatori, e lo stesso vale per l'utilizzo di una nuova versione del dataset per riaddestrare il modello (anche se questi processi potrebbero richiedere molto tempo, nel frattempo gli sviluppatori possono comunque concentrarsi su altre attività)
Passi successivi
Siamo ancora nel processo di "adozione di MLOps" in BEPRO, quindi ci sono diversi passi successivi ovvi, alcuni dei quali sono:
Estensione ad altre attività
Valutazione di diversi schemi di ponderazione dei campioni
Pseudo-etichettatura dei campioni per i quali non disponiamo di annotazioni di esperti umani (con questo approccio diventano disponibili molti più campioni con condizioni diverse)
È anche interessante valutare il rendimento a lungo termine della raccolta continua di dataset e del riaddestramento dei modelli. Finora siamo stati in grado di ottenere miglioramenti incorporando più dati nel tempo, ma si prevede che questi saranno decrescenti e che nel tempo saranno molto probabilmente limitati dalla capacità/architettura del modello.